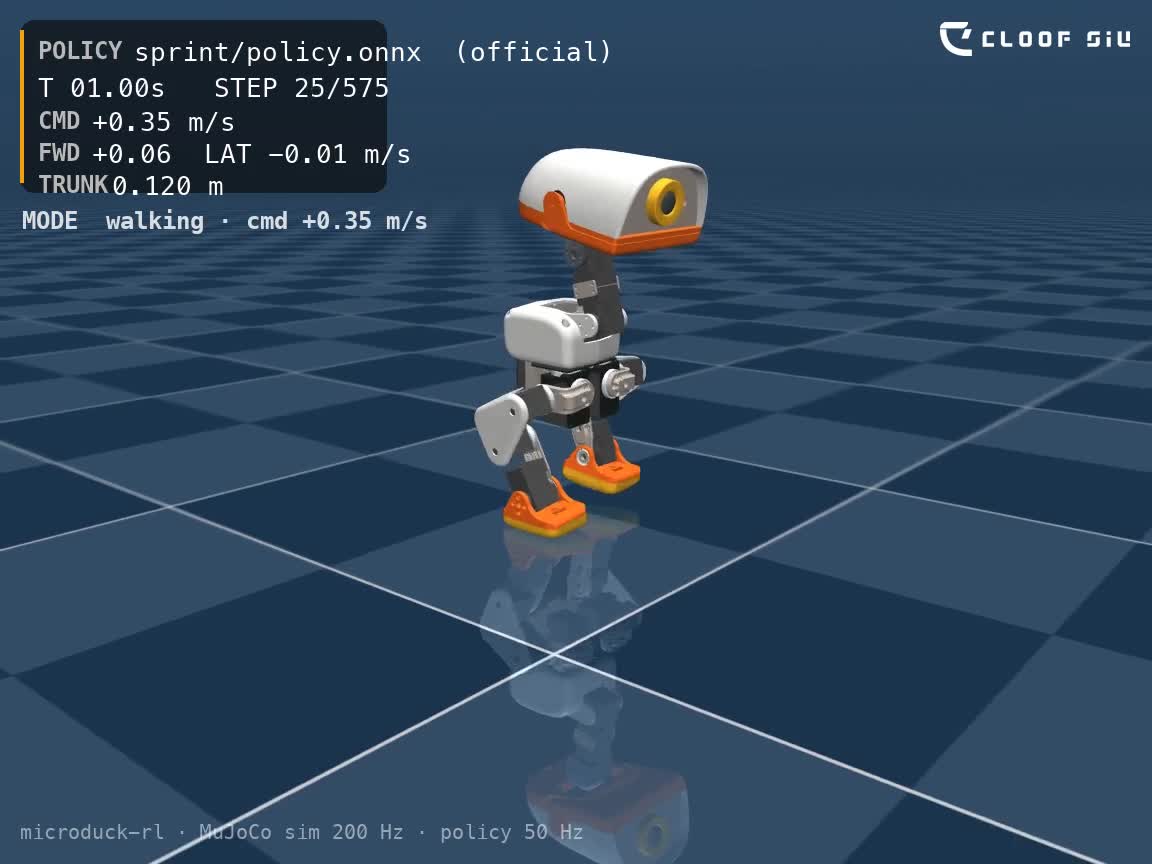
Pollen Robotics(開源人形機械人 Reachy 背後的法國團隊)為其新推出、約 25cm/約 800g 的雙足機械人 Microduck 開源了整套強化學習訓練系統:超過 44 個 RL 任務環境、完整的 sim2real 方案,以及真機上運行的全部 policy。即使沒有實體機械人,亦可使用。本文是我在家中電腦安裝該系統、在模擬器中操作三個環境,並在 6GB 的 RTX 2060 上從零訓練一個行走 policy 的完整紀錄,當中包括真實數據及我遇過的問題。
alpha_walking 參考 policy 在平地上衝刺。指令 0.35 m/s,直線行走:11.5 秒內前進 5.9 米。1 · 所需配置
| 部件 | 最低要求 | 備註 |
|---|---|---|
| GPU(訓練) | 任何 CUDA 顯示卡,約 6GB VRAM | RTX 2060 6GB 運行 2048 個並行環境只佔用 3.7GB;8GB 或以上可支援 4096 個(上游預設值)。 |
| GPU(只操作、不訓練) | 不需要,CPU 亦可 | Policy 推理及 3D viewer 毋須 CUDA 亦可正常運行。 |
| RAM/磁碟 | 16GB/約 10GB 空間 | 首次執行 uv sync 會下載約 2GB CUDA wheels(torch 2.9.1 cu128、MuJoCo Warp)。 |
| 作業系統 | Ubuntu(原生或 WSL2) | 本文所有步驟均在 Windows 11 + WSL2 + NVIDIA WSL 驅動程式環境下運行。 |
2 · 安裝(15 分鐘)
只需數行指令即可完成。uv 是本項目使用的 Python 套件管理器;由於首次 sync 會下載約 2GB 指定版本的 CUDA wheels,需要將 HTTP timeout 延長。
curl -LsSf https://astral.sh/uv/install.sh | sh
git clone https://github.com/pollen-robotics/microduck_rl
cd microduck_rl
export UV_HTTP_TIMEOUT=600
uv sync          # 首次約 2GB,光纖網絡下少於 10 分鐘
uv run list-envs # 任務登記表:44 個任務
list-envs 會列出全部任務:行走、起身、坐下與站立、蹲下拾物、踢球、前滾翻(roulade)、滾軸溜冰(六個 roller 任務),以及每個任務均設有的 Backlash 版本(在每個關節齒輪加入真實齒隙)。每個任務都是一個獨立的 PPO gym。
nvidia-smi 確認。我的電腦顯示 NVIDIA GeForce RTX 2060, 6144 MiB,import torch 後 torch.cuda.is_available() == True。3 · 下載真機正在使用的 policy
Pollen 將實體 Microduck 所運行的網絡全部發佈於 Hugging Face,共 11 個 ONNX 檔案,每個約 800KB。換言之,你可以在模擬器中運行與真機相同的神經網絡。
uv run python - <<'EOF'
from huggingface_hub import snapshot_download
snapshot_download(repo_id="pollen-robotics/microduck-policies",
                  local_dir="/home/<你>/microduck_policies")
EOF
4 · 以鍵盤操控 policy
Repo 中的 scripts/infer_policy.py 會載入場景、掛上 ONNX policy,並以 50Hz 在一般桌面 viewer 中運行 MuJoCo,所用的 actuator 模型、控制頻率及觀察協議均與真機相同:
uv run scripts/infer_policy.py
  --walking ~/microduck_policies/velstand.onnx
--new-cmd-obs| 按鍵 | 作用 |
|---|---|
| ↑ / ↓ | 前進速度 +/−(上限 0.3m/s) |
| ← / → | 側移(velstand 支援橫向追蹤) |
| A / E | 轉向 ±1.5rad/s |
| 空白鍵 | 指令歸零,同一個 policy 會保持站立 |
| P | 以 1.0m/s 向隨機方向推撞軀幹(訓練中最大的推撞) |
| K / L / R | 踢球(左/右)/前滾翻(需同時載入對應的 ONNX) |
| Q | 離開 |
只要加上 –kick-left / –kick-right,官方的踢球場景便會自動載入(同樣需要 –new-cmd-obs),示範③正是以此方式完成。
5 · 三段影片的錄製方法(無畫面 headless 輸出)
上述三段影片全部是同一個 loop 直接以 MuJoCo 渲染而成。我編寫了一個約 180 行的 script:重用 repo 本身的 PolicyInference 類別,運行同一套物理設定(每個控制 tick 4 個子步、BAM 電壓 actuator),以 MuJoCo EGL 後端進行離屏渲染,並將 frame 直接 pipe 至 ffmpeg:
MUJOCO_GL=egl uv run python cloof_demo.py --demo walk    # / recovery / kick
# 1152x864、25fps、每 2 個控制步輸出 1 frame、libx264 CRF21MUJOCO_GL=egl;將 model.vis.global_.offwidth / offheight 調至大於預設的 640×480;以及加上 scene.flags[mjRND_SHADOW] = 0 以消除條紋陰影瑕疵。完整 script 已附於文末的 code block,直接貼入 scripts/ 即可使用。6 · 在 6GB 顯示卡上自行訓練行走 policy
一行指令即可在 2048 個並行環境中啟動 PPO:
uv run train Mjlab-Velocity-Flat-MicroDuck
  --env.scene.num-envs 2048
  --agent.logger tensorboard
  --agent.max-iterations 2000
  --agent.run-name cloof_local_2048
RTX 2060 的實際數據:
| 設定 | 數值 |
|---|---|
| 1024 個環境(測試) | 3.0 秒/iter · 1.25GB VRAM |
| 2048 個環境(正式運行) | 3.5–3.7 秒/iter · 3.7/6.1GB VRAM · GPU 使用率約 49% |
| 2000 個 iteration(已完成) | 2 小時 01 分 · 98,304,000 步模擬 · 最終 mean reward 108/episode 長度 940/跌倒次數 0.375 |
| Checkpoints | logs/rsl_rl/<run>/model_NNNN.pt(訓練期間持續儲存;以 Ctrl-C 中止後,可用 --agent.load-checkpoint 繼續訓練) |
--agent.logger tensorboard:預設 logger 為 wandb,需要帳戶及 API key。TensorBoard 的所有資料均保留在本機,執行 uv run tensorboard --logdir logs/rsl_rl 即可觀察 reward 上升(即機械人逐步學會行走)。匯出(exporter 會將觀察 normalizer 寫入 ONNX graph,這是產生可部署檔案的唯一途徑):
uv run scripts/export.py Mjlab-Velocity-Flat-MicroDuck
  --checkpoint-file logs/rsl_rl/<yours>/model_1999.pt
# 匯出後,可使用與官方 policy 相同的推理 loop 運行:
uv run scripts/infer_policy.py
  --walking my_new_walk.onnx --new-cmd-obs --lin-vel-x 0.22
上方第四段影片便是我在這次訓練中得出的 model,與官方 policy 使用同一個推理 loop。
7 · 數據帶給我的啟示
- 我兩小時的本地 PPO 訓練:穩定但保守。最終 checkpoint 在所有測試中均未曾跌倒;指令為 0.30 時追蹤至約 0.13m/s,指令為 0.50 時追蹤至約 0.28m/s(約 56%),而且存在死區:指令低於約 0.25 時便原地站立不動。官方 sprint 參考版本行得較快(0.53m/s),但一張家用 6GB 顯示卡已模擬了 9,830 萬步,所謂「通宵訓練」其實只花了一個悠閒的晚上。
- 官方預設的「行走」policy 刻意設計得較保守。
velstand.onnx(真機預設的 policy,以崎嶇地形及齒隙條件訓練)在平坦場景中,指令為 0.22m/s 時只達到約 0.07m/s。我以官方推理 loop 重現了相同比率,證明並非我接駁出錯:它以追蹤表現換取穩健性。不過,它的轉向及起身表現依然出色。 - 需要速度時應使用 sprint 參考 policy。Pollen 另行發佈參考 policy(例如 microduck-sprint-2m):sprint 參考版本在 0.35m/s 指令下達到 0.53m/s(由於它是為 2 米短跑而訓練,因此會超速),直線行走十分漂亮,但若同時加入急轉彎便會跌倒。
- 起身才是最大亮點。VelStand v8 將「跌倒後起身」訓練進行走 policy 本身:影片中的機械鴨被 1.15m/s 推撞後側身倒地,約 1 秒後便重新站起。
- 整個系統以 ONNX 為核心。Policy 在 GPU(MuJoCo Warp)上訓練,再匯出為 61→14 維的 ONNX;同一個檔案可在模擬器、真機及任何支援 ONNX Runtime 的環境中運行,因此「下載官方檔案→本地運行」毋須任何膠水代碼。
8 · 下一步
- 以 Pollen 的 checkpoint 作 warm-start,再於平地上微調,即「policy remix」;如有真機,可部署回實體機械人。
- 嘗試崎嶇地形(rough terrain)及斜坡任務;環境代碼在每次 reset 時都會隨機生成地形。
- 教學角度:真機上的 61→14 協議容許以一個按鈕切換 walk→recover→kick,對學習 AI 的學生而言,是「model switching」一個非常具體的實例。
- 滾軸溜冰任務系列(共六個)訓練腳下裝有被動輪的機械人,是最具娛樂性的示範素材,已列入我的待辦清單。
來源及授權
- Repo:pollen-robotics/microduck_rl(Apache 2.0)。項目主頁:pollen-robotics/microduck。Policies:pollen-robotics/microduck-policies。
- 訓練底層:mjlab(MuJoCo Warp + PPO)及 BAM actuator 模型(Rhoban)。
- 3D 模型檔案採用 CC BY-NC-SA 授權(網格只限非商業用途);上述代碼採用 Apache 2.0 授權。
- 文中所有影片均由我在家中的模擬運行輸出。© 2026 Cloof Siu。
附錄 · 完整 headless 渲染 script
cloof_demo.py:按此展開(貼入 repo 的 scripts/ 目錄)
#!/usr/bin/env python3
"""Headless demo-video recorder for microduck_rl (Cloof tooling).

Runs the official ONNX policies through the SAME loop as
scripts/infer_policy.py (BAM actuators, 50 Hz control, decimation 4),
renders offscreen with MuJoCo EGL, and pipes frames into ffmpeg.

Demos:
  walk      velstand protocol: stand -> forward -> strafe -> turn -> forward
  recovery  velstand: get pushed 1 m/s (curriculum cap) and recover
  kick      scene_ball.xml: kick left, then kick right
"""
import argparse
import json
import math
import os
import subprocess
import sys

os.environ.setdefault("MUJOCO_GL", "egl")

import numpy as np  # noqa: E402

REPO = "/home/cloofsiu/microduck_rl"
POLICIES = "/home/cloofsiu/microduck_policies"
sys.path.insert(0, os.path.join(REPO, "scripts"))
import infer_policy as ip  # noqa: E402
import mujoco  # noqa: E402

DEMO_DATA = {
    "walk": {
        "scene": ip.MICRODUCK_XML,
        "sessions": {"walking_onnx_path": f"{POLICIES}/../microduck_sprint/policy.onnx"
                     if os.path.exists(f"{POLICIES}/../microduck_sprint/policy.onnx")
                     else f"{POLICIES}/velstand.onnx"},
        "plan": [
            (0.5, "vel", (0.35, 0.0, 0.0)),
            (9.8, "vel", (0.0, 0.0, 0.0)),
        ],
        "seconds": 11.5,
    },
    "local": {
        "scene": f"{REPO}/src/mjlab_microduck/robot/microduck/scene_walk.xml",
        "sessions": {"walking_onnx_path": f"{REPO}/output.onnx"},
        "plan": [
            (0.5, "vel", (0.30, 0.0, 0.0)),
            (9.8, "vel", (0.0, 0.0, 0.0)),
        ],
        "seconds": 11.5,
    },
    "recovery": {
        "scene": ip.MICRODUCK_XML,
        "sessions": {"walking_onnx_path": f"{POLICIES}/velstand.onnx"},
        "plan": [
            (1.5, "push", (1.15, math.radians(105))),
            (7.5, "vel", (0.35, 0.0, 0.0)),
            (9.8, "vel", (0.0, 0.0, 0.0)),
        ],
        "seconds": 10.5,
        "push": 1.15,
    },
    "kick": {
        "scene": ip.MICRODUCK_BALL_XML,
        "sessions": {
            "walking_onnx_path": f"{POLICIES}/velstand.onnx",
            "kick_left_onnx_path": f"{POLICIES}/ball_kick_left.onnx",
            "kick_right_onnx_path": f"{POLICIES}/ball_kick_right.onnx",
            "kick_duration": 3.0,
        },
        "plan": [
            (1.2, "kick", "kick_left"),
            (4.5, "kick", "kick_right"),
        ],
        "seconds": 7.5,
    },
}


def trunk_addresses(model):
    jid = mujoco.mj_name2id(model, mujoco.mjtObj.mjOBJ_JOINT, "trunk_base_freejoint")
    return int(model.jnt_qposadr[jid]), int(model.jnt_dofadr[jid])


def build(spec, action_scale=1.0, width=1152, height=864):
    bam_model = ip.load_bam_model(ip.BAM_KP_FW, 7.4, ip.BAM_MAX_CURRENT)
    model, data, bam_ctrl, _names = ip.load_mujoco_with_bam(
        spec["scene"], bam_model, 0.005, None, ip.BAM_VIN_MIN)
    model.vis.global_.offwidth = max(width, 640)
    model.vis.global_.offheight = max(height, 480)
    policy = ip.PolicyInference(
        model, data, bam_ctrl=bam_ctrl, action_scale=action_scale,
        use_projected_gravity=True, new_cmd_obs=True,
        **spec["sessions"])
    qpos_adr, qvel_adr = trunk_addresses(model)
    data.qpos[qpos_adr:qpos_adr + 2] = 0.0
    data.qpos[qpos_adr + 2] = 0.125
    data.qpos[qpos_adr + 3:qpos_adr + 7] = [1, 0, 0, 0]
    for i, idx in enumerate(policy.joint_qpos_indices):
        data.qpos[idx] = policy.default_pose[i]
    if spec["scene"] == ip.MICRODUCK_BALL_XML:
        bj = mujoco.mj_name2id(model, mujoco.mjtObj.mjOBJ_JOINT, "ball_free")
        bqa = int(model.jnt_qposadr[bj])
        data.qpos[bqa:bqa + 3] = [-0.5, 0.35, 0.035]
        data.qpos[bqa + 3:bqa + 7] = [1, 0, 0, 0]
    bam_ctrl.reset(data.qpos)
    policy.set_position_targets(policy.default_pose)
    mujoco.mj_forward(model, data)
    policy.vel_max_x, policy.vel_min_x = 0.3, -0.3
    policy.vel_max_y, policy.vel_min_y = 0.2, -0.2
    policy.vel_max_ang = 1.5
    return model, data, bam_ctrl, policy, qpos_adr, qvel_adr


def plan_op(plan, t):
    for (pt, kind, args) in plan:
        if abs(t - pt) < 0.01:
            return kind, args
    return None, None


def run(demo, out_dir, width, height, fps_div, push_mag=None):
    spec = dict(DEMO_DATA[demo])
    if push_mag is not None:
        spec["plan"] = [(t, k, (push_mag, a) if k == "push" else v)
                        for (t, k, v) in spec["plan"]]
    model, data, bam_ctrl, policy, qpos_adr, qvel_adr = build(spec, width=width, height=height)
    os.makedirs(out_dir, exist_ok=True)
    mp4 = os.path.join(out_dir, f"duck_{demo}.mp4")

    from mujoco import Renderer
    metrics = {"demo": demo, "steps": 0, "control_dt": 0.02,
               "vel_avg": [], "frames": 0}
    renderer = None
    ffmpeg = None
    try:
        renderer = Renderer(model, height=height, width=width)
        cam = mujoco.MjvCamera()
        cam.azimuth = 130
        cam.elevation = -14
        cam.distance = 0.78

        ffmpeg = subprocess.Popen([
            "ffmpeg", "-y", "-loglevel", "error",
            "-f", "rawvideo", "-pix_fmt", "rgb24",
            "-s", f"{width}x{height}", "-r", "25", "-i", "pipe:",
            "-c:v", "libx264", "-preset", "medium", "-crf", "21",
            "-pix_fmt", "yuv420p", "-movflags", "+faststart", mp4,
        ], stdin=subprocess.PIPE)

        decim = 4
        control_dt = decim * model.opt.timestep
        n_steps = int(spec["seconds"] / control_dt)
        metrics["steps"] = n_steps
        metrics["control_dt"] = control_dt
        frame_every = max(1, fps_div)
        vel_hist = []
        start_pos = None
        for step in range(n_steps):
            t = step * control_dt
            kind, args = plan_op(spec["plan"], t)
            if kind == "vel":
                policy.set_vel_cmd(*args)
                print(f"[{t:5.1f}s] cmd -> {args}", flush=True)
            elif kind == "push":
                mag, ang = args
                data.qvel[qvel_adr + 0] = mag * math.cos(ang)
                data.qvel[qvel_adr + 1] = mag * math.sin(ang)
                print(f"[{t:5.1f}s] PUSH {mag:.2f} m/s @ {math.degrees(ang):.0f} deg", flush=True)
            elif kind == "kick":
                policy.trigger_behavior(args)
                print(f"[{t:5.1f}s] trigger {args}", flush=True)

            policy.update_ground_pick_phase(control_dt)
            policy.update_behavior(control_dt)
            action = policy.infer()
            policy.apply_action(action)
            for _ in range(decim):
                bam_ctrl.update()
                mujoco.mj_step(model, data)

            quat = data.qpos[qpos_adr + 3:qpos_adr + 7].astype("float32")
            v_w = data.qvel[qvel_adr:qvel_adr + 3].astype("float32")
            v_b = policy.quat_rotate_inverse(quat, v_w)
            vel_hist.append((float(v_b[0]), float(v_b[1]), float(t)))
            if len(vel_hist) > 50:
                vel_hist.pop(0)
            if step % 50 == 0:
                avg = tuple(float(sum(v[i] for v in vel_hist) / len(vel_hist)) for i in (0, 1))
                metrics["vel_avg"].append({"t": round(float(t), 2), "fwd": round(avg[0], 3),
                                           "lat": round(avg[1], 3),
                                           "cmd": [float(policy.vel_cmd[0]), float(policy.vel_cmd[1])],
                                           "trunk_z": round(float(data.qpos[qpos_adr + 2]), 4),
                                           "policy": policy.current_policy})
            if start_pos is None:
                start_pos = np.array(data.qpos[qpos_adr:qpos_adr + 2])
            if step % frame_every == 0:
                p = data.qpos[qpos_adr:qpos_adr + 3]
                cam.lookat[:] = [p[0], p[1], max(0.02, float(p[2]) * 0.55)]
                renderer.update_scene(data, camera=cam)
                renderer.scene.flags[mujoco.mjtRndFlag.mjRND_SHADOW] = 0
                img = renderer.render()
                ffmpeg.stdin.write(img.tobytes())
                metrics["frames"] += 1
        ffmpeg.stdin.close()
        ffmpeg.wait()
        metrics["travelled_m"] = round(float(np.abs(data.qpos[qpos_adr:qpos_adr + 2] - start_pos).sum()), 3)
        with open(os.path.join(out_dir, f"duck_{demo}_metrics.json"), "w") as f:
            json.dump(metrics, f, indent=2)
    finally:
        if renderer is not None:
            try:
                renderer.close()
            except Exception as exc:
                print(f"renderer close warning: {exc}", flush=True)
        if ffmpeg is not None and ffmpeg.stdin is not None and not ffmpeg.stdin.closed:
            ffmpeg.stdin.close()
            ffmpeg.wait(timeout=60)
    print(f"DONE {mp4}  travelled={metrics.get('travelled_m')}", flush=True)


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--demo", required=True, choices=list(DEMO_DATA))
    ap.add_argument("--out", required=True)
    ap.add_argument("--width", type=int, default=1152)
    ap.add_argument("--height", type=int, default=864)
    ap.add_argument("--fps-div", type=int, default=2)
    ap.add_argument("--push", type=float, default=None)
    a = ap.parse_args()
    run(a.demo, a.out, a.width, a.height, a.fps_div, a.push)


if __name__ == "__main__":
    main()